
在使用AI生成图片或视频时,如果画面里只有一个角色,不管你怎么描述,AI基本都能乖乖听话。但只要画面里出现两个或以上的角色,不管你的提示词打磨得多么精准、动作描写得多么详细,人物依然极难控制。
尤其是当你对画面整体很满意,唯独需要单独修改其中一个人的动作时,结果会非常不可控——改了左边,右边跟着变异,甚至连原本完美的动作也丢失了。整个“抽卡”过程宛如开盲盒,极其消耗算力和耐心。
今天,我不讲那些复杂的节点连线操作,纯粹从提示词与AI底层逻辑出发,教你3个高阶提示词技巧。无论你使用的是 即梦、可灵、海螺 这类头部视频模型,还是 Nano Banana Pro、Midjourney 这类图像模型,只要掌握这3点,你就能精准拿捏每个角色的动作!
方法一:抛弃“流水账”,用“时间段/空间感”拆分动作
底层原理:现在的AI不傻,但它会“抓错重点”
很多人以为AI像人一样,能读懂复杂的长句和先后顺序。 实际上,目前的头部模型(如即梦、可灵)虽然语义理解极强,
早就不会再犯“把女人的红裙子穿在男人身上”这种低级的特征污染错误。
但如果你在同一句话里塞入多个角色的多个动作,AI的注意力机制就会发生“算力偏移”或“动作稀释”。
它无法均衡地分配算力给每一个人。
结果就是:它只能保住其中一个角色的动作,而让另一个角色沦为静止的“背景板”,或者完全无视你自然语言里的先后顺序。
常见的错误方法:“流水账式”写法
90%的新手都犯过这个致命错误,就是把所有的人物和动作,一股脑地写在同一句话里。
错误示例:
“在一个咖啡厅里,左边的男人正在喝咖啡,同时右边的女人在开心地跳舞,接着男人站起来鼓掌。”
这种写法人类看着通顺,但AI拿到后,经常会生成这样的结果:右边的女人确实在跳舞,但左边的男人一边端着咖啡杯一边诡异地强行鼓掌。AI根本理不清“同时”和“接着”这种复杂的时序节奏。
正确写法:结构化的“空间占位”与“时间段”
我们需要用极其生硬的结构化语言,帮AI理清画面的重点和时间轴。
视频生成(如 可灵 / 海螺 / 即梦):用时间段拆解很多AI视频模型对“时间轴标签”的理解,远比对“接着”、“然后”这类自然语言的理解更精准。当动作被拆成不同的时间段之后,AI就能明确每一秒的算力该集中在谁身上。
正确示范:
[0-3秒] 左侧区域,一名穿黑西装的男人坐在椅子上,端着杯子喝咖啡;右侧区域,一名穿红裙的女人正在开心地跳舞。
[4-8秒] 右侧女人的跳舞动作保持不变;左侧男人将咖啡杯放在桌子上,站起身来,双手开始鼓掌。
方法二:抛弃传统蒙版,善用“视频编辑”锁定满意角色
底层原理:语义替换 vs 传统重绘
过去,当我们想修改视频里其中一个人的动作时,第一反应是“去画个蒙版”把他框出来。但这在AI视频生成中是个大坑——动态视频的蒙版很难完美贴合每一帧,极容易导致修改边缘严重闪烁,人物像个劣质贴图。
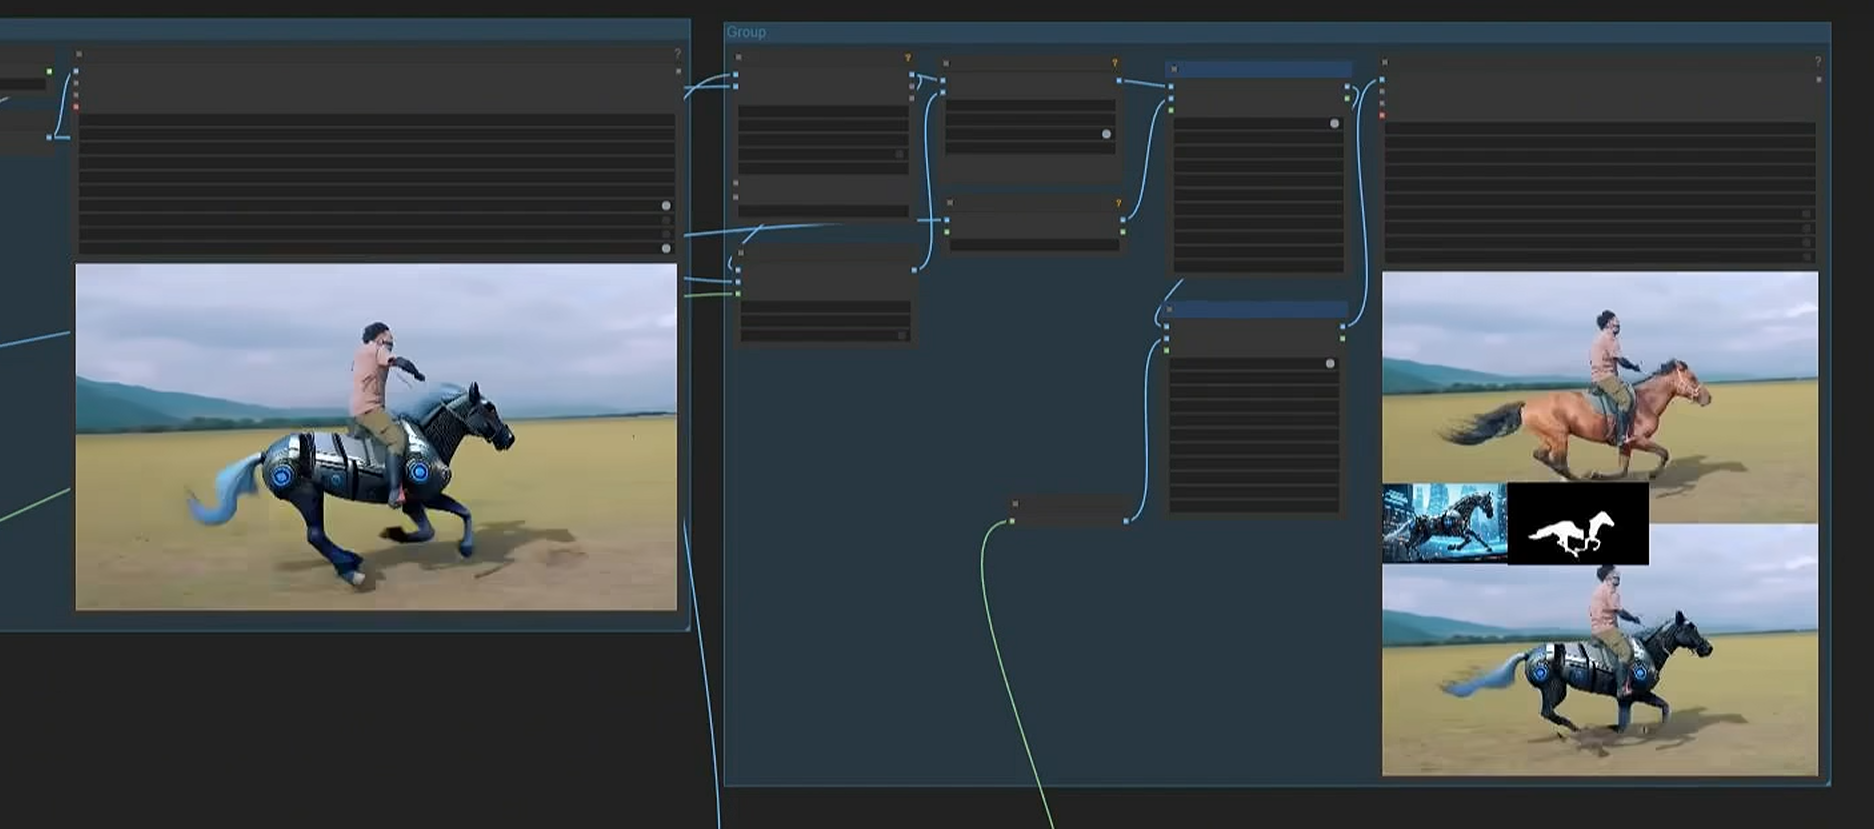
而到了2026年,头部视频模型(如即梦Seedance 2.0、可灵Omni)的底层已经进化到了“语义级视频编辑”。AI能直接通过你的自然语言,在潜空间里精准识别出“谁是谁”,直接在对应的像素特征上做动作替换,完全不需要你手动去抠图。
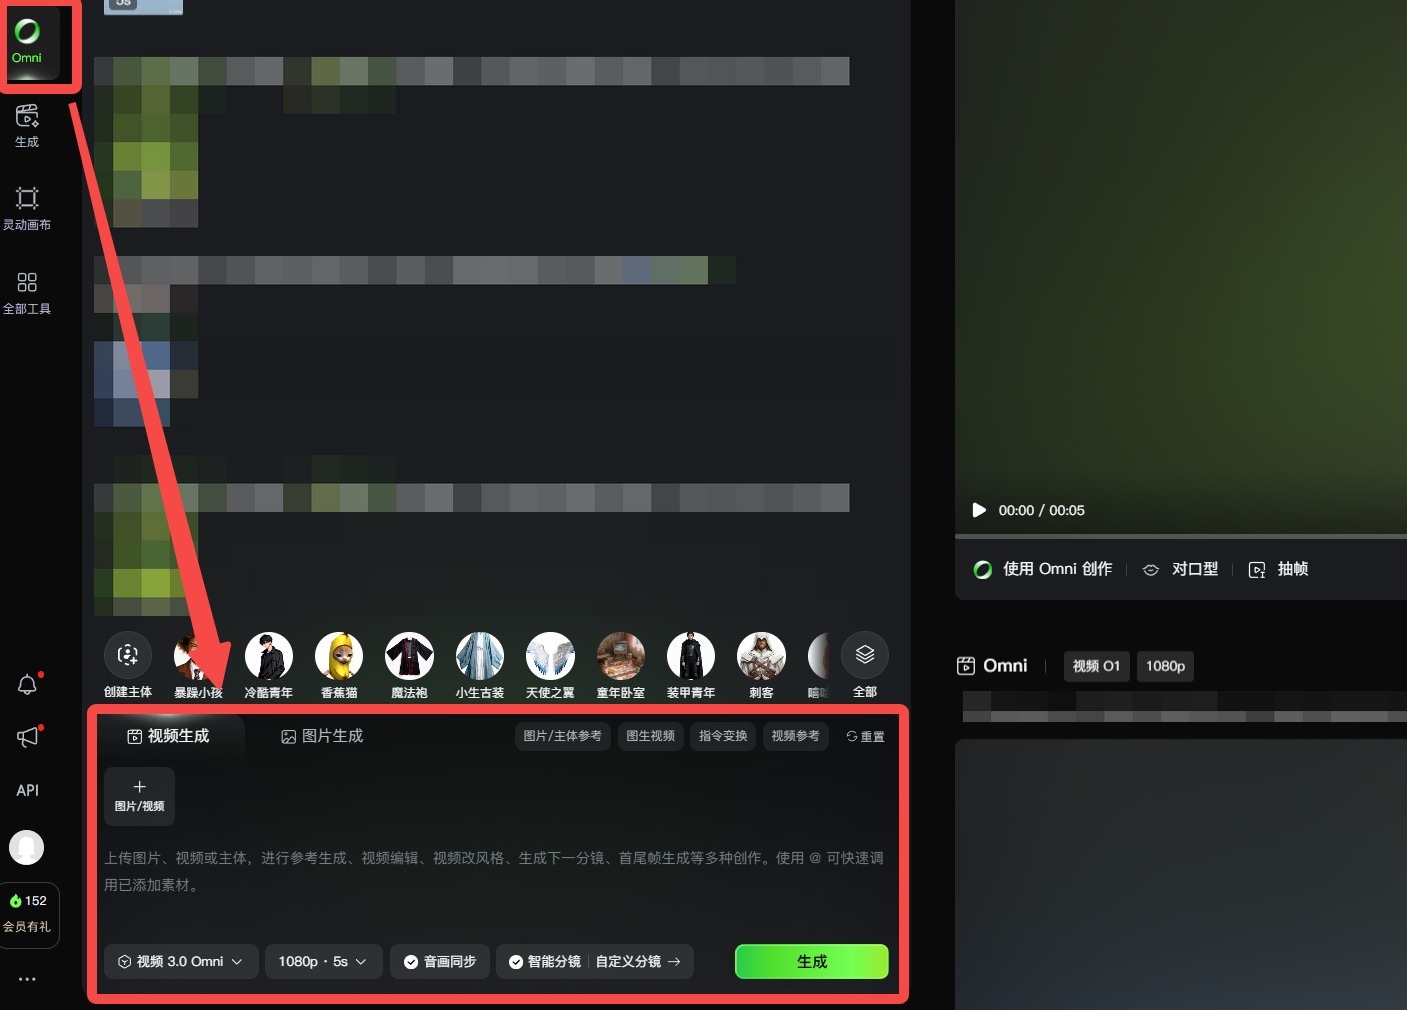
常见的错误方法:盲目抽卡 或 傻傻画蒙版
当你对画面右侧的角色满意,只对左侧不满意时:如果你直接在原提示词里加上“左边男人换个动作”并点击重新生成,AI会进行全局重绘,把你原本满意的右侧人物也彻底刷掉,让你前功尽弃。
正确写法:利用原生“视频编辑”功能,明确“留与改”
我们完全可以通过主流工具内置的编辑功能,用一句话完成精准的“换角/改动作”。
如果你追求高效出片(以 可灵 Omni 为例):可灵 Omni 拥有极强的语义理解能力。你只需在原视频上使用【视频编辑】功能,输入一句带有“锁定+修改”双重指令的话。
注意:这里有一个绝不能踩坑的万能公式——一定要在提示词里明确写出“被保留的是哪一部分”。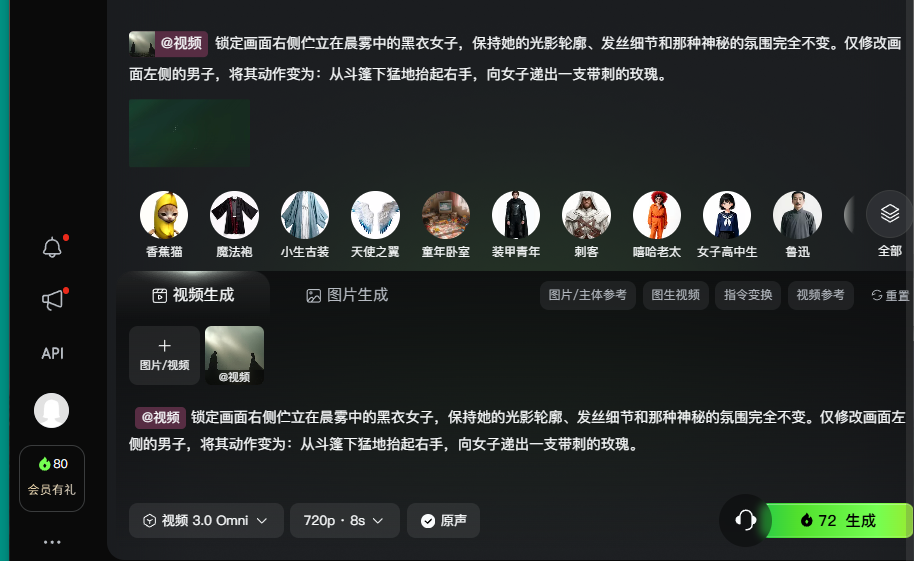
正确示范(语义替换万能公式):
锁定画面右侧伫立在晨雾中的黑衣女子,保持她的光影轮廓、发丝细节和那种神秘的氛围完全不变。仅修改画面左侧的男子,将其动作变为:从斗篷下猛地抬起右手,向女子递出一支带刺的玫瑰。
你不说保留,AI这愣头青就会默认你要全部推翻。利用好语义编辑,不仅省去了画蒙版的麻烦,还能完美保留原视频的环境光影和质感。
附件资料
 2026版 AI多角色视频“语义编辑”实战提示词宝典.docx
方法三:把复杂动作拆成多个阶段(用运镜打破AI摆拍感)
底层原理:算力溢出后的“视听语言”博弈
很多人控制多人动作失败,还有一个原因,就是给角色安排了过于复杂的连续动作。
你可能会反驳:
“在如今的即梦 Seedance 2.0 看来,这种提示词‘男人拔出剑,向前冲刺,躲开女人的攻击,然后在空中转体360度劈砍落地’根本就不会崩!”
没错,现在的AI算力已经极其恐怖,即使你把这么多高难度动作塞进去,人物的四肢依然能保持健全且流畅。但既然不会崩,我们为什么还要拆分?
因为如果你习惯把动作写成“清单”一股脑塞进长镜头里,甚至把动作的“结果”当成“过程”来写,画面就会失去所有的微表情和动作细节。成片效果会非常像一个“监控探头”拍出来的廉价游戏CG,毫无张力,充满了浓厚的“AI摆拍感”。
常见的错误方法:把动作清单当成电影剧本
只关注人物“做完了一套什么动作”,却忽略了镜头“怎么拍”。把几十秒的高光动作戏全部挤在一个全景镜头里,不仅没有视觉冲击力,还极度缺乏真实感。我们不能总是把AI视频的摆拍感归咎于提示词不够完美,更要从镜头语言上找原因。
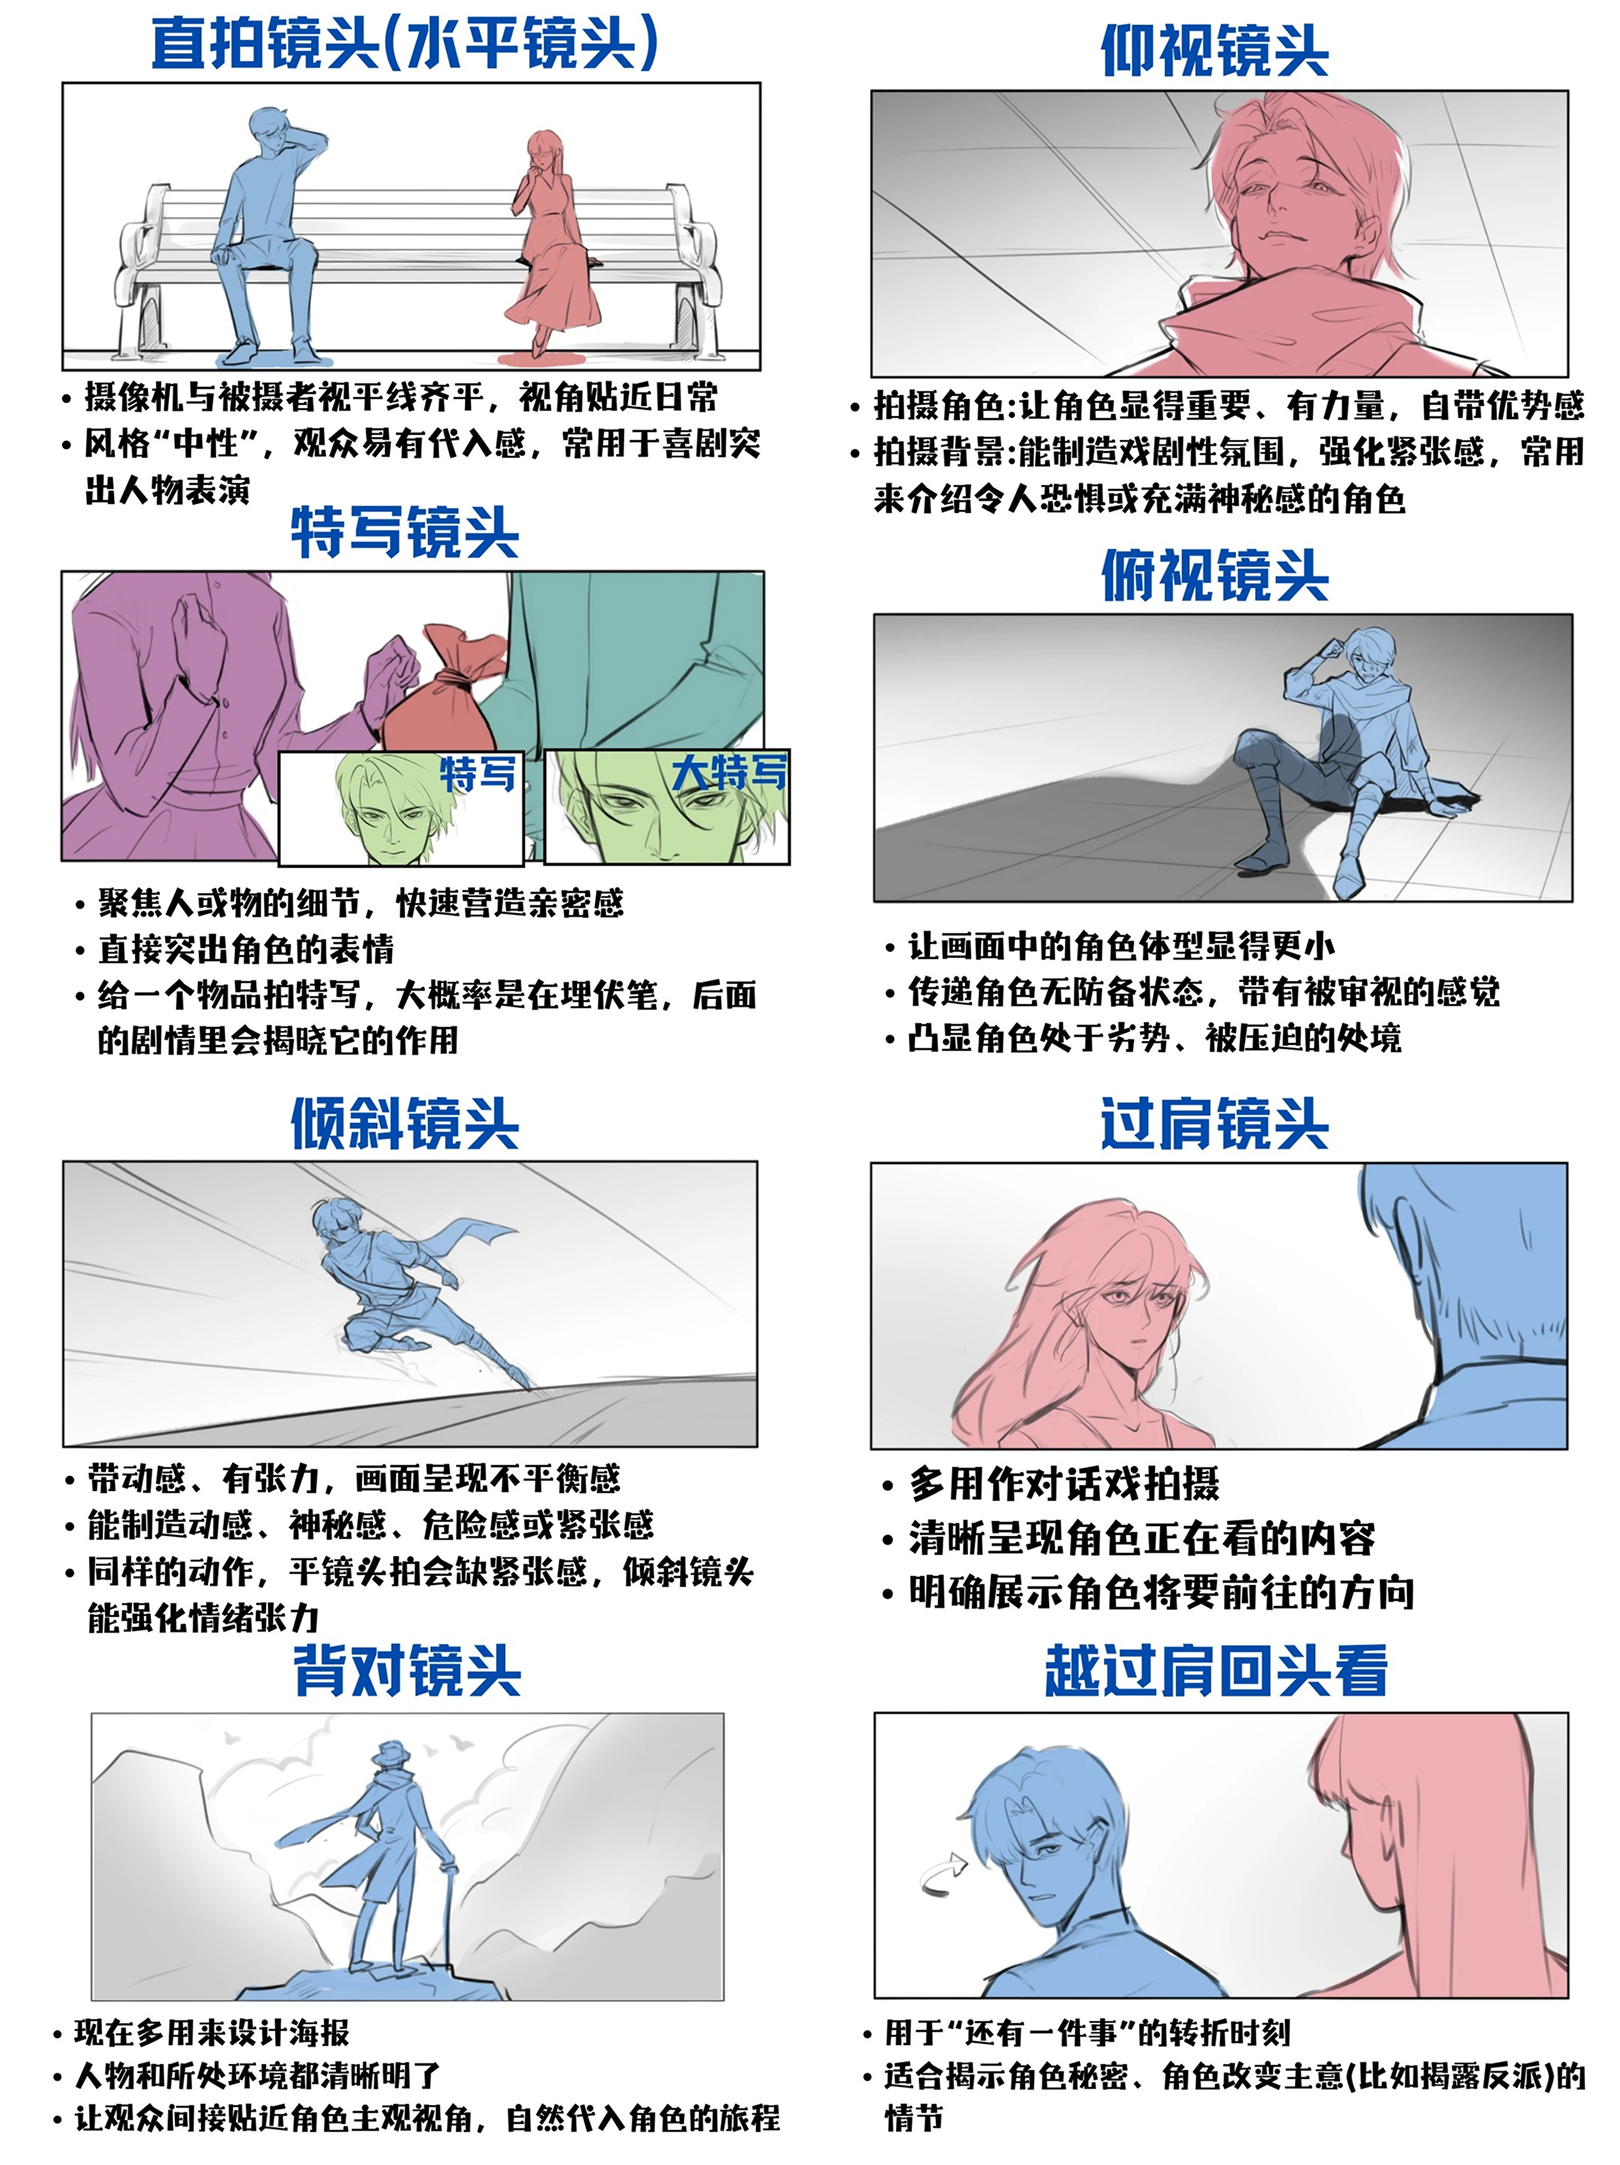
镜头参考(来源于网络)
正确写法:用分镜和运镜拆解动作阶段
真正高级、具备商业落地价值的做法是:具备导演思维,把复杂动作拆分成多个极具视觉冲击力的分镜。
很多看起来动作极度震撼的AI短片,并不是一次生成出来的,而是拆成多个阶段“接力”生成的:
电影级美学场景假设:夏日复古车站的告别
第一阶段(特写 - 情绪铺垫): 先用图像工具生成高清底图,只拍动作前摇。
脸部特写。左侧女主眼眶微红,发丝在微风中凌乱,手中紧紧攥着一张老旧车票;
第二阶段(中景 - 动作爆发): 切换景别,加快节奏。
中景,跟拍。女主突然松开手,任由车票飘落,转身向着光影中的男主奔跑。
提示词:
0s-2s:特写@image_1手中的车票,她紧紧攥住那张旧车票。
2s-5s: 女主突然完全松开右手,任由那张老旧车票飘落到站台地面。镜头跟踪车票缓缓下至地面
5s-8s 她猛地转身,向着远处光影中的男主快速奔跑,裙摆在强风中剧烈飘动,背景中原本虚化的男子的剪影听到声音后,惊讶地转过身来,如@image_2。
第三阶段(全景 - 高潮定格): 慢动作升格,拉满张力。
全景,升格慢动作。两人在站台中央相拥,一列老式火车从旁边呼啸而过,强风扬起她裙摆。
提示词:
0s-3s:女生从右上侧跑过来与男生拥抱在一起
3s-6s:拥抱过后,电车超快速驶过,引起镜头晃动。强风扬起女生的裙摆和头发
随后将视频拼接:
核心避坑指南(极其重要):我们在多阶段接力生成多个镜头时,千万不要有强迫症。现在生成的图片和视频,背景通常都差不多角度,你只需要在提示词里保证“统一的环境描述”(比如始终写“昏暗的古风酒馆”)即可,完全不需要去强求每一段视频的背景连一块砖的纹理都一模一样。 在动态的景别切换中,观众的视觉重心完全在人物动作和运镜张力上,些微的背景变化会被大脑自动忽略。
总结
控制多角色动作,本质上是在考验你驾驭AI的思维方式:
拆时间/空间:用结构化语言,避免AI抓错重点导致动作丢失。
用语义编辑:抛弃旧版蒙版,用一句话精准锁定并修改满意角色。
拆分复杂动作:拒绝长镜头清单,用分镜运镜打破监控探头式的摆拍感。
其实很多时候,AI视频做不好并不是因为工具不行,而是因为我们太心急。慢慢学习,吃透这些视听语言和机器底层的逻辑,才能让自己真正有所提升,把AI变成你手中指哪打哪的生产力。
角色设计执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是让你照着参考图抄脸,而是围绕「90%的人踩坑:AI视频多角色失控?3个技巧拿捏!」把原创角色脸拆成结构、比例、五官主次和妆造记忆点。
按原文节奏走最稳:先吃透「方法一:抛弃“流水账”,用“时间段/空间感”拆分动作」,再把「方法二:抛弃传统蒙版,善用“视频编辑”锁定满意角色」定住,接着处理「方法三:把复杂动作拆成多个阶段(用运镜打破AI摆拍感)」;最后用「总结」收口。
- 把「方法一:抛弃“流水账”,用“时间段/空间感”拆分动作」这一点先定准,再往下走。
- 围绕「方法二:抛弃传统蒙版,善用“视频编辑”锁定满意角色」收一收五官,不要让每个部位都抢戏。
- 把「方法三:把复杂动作拆成多个阶段(用运镜打破AI摆拍感)」这一点先定准,再往下走。
- 先把「总结」里说的脸型或气质定住。
- 围绕「底层原理:现在的AI不傻,但它会“抓错重点”」收一收五官,不要让每个部位都抢戏。
- 做完「常见的错误方法:“流水账式”写法」后,先确认角色还是原创。
不要直接套真人脸或影视角色脸;不要把所有五官都做成强特征,否则容易撞脸、割裂、不稳定。
检查角色是否有清晰记忆点;年龄感和气质是否一致;换妆造后脸是否稳定;是否不像任何明确真人或影视角色。
请围绕「90%的人踩坑:AI视频多角色失控?3个技巧拿捏!」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:角色定位、脸型方向、三庭五眼比例、五官主次、妆造记忆点、完整生图提示词。要求原创、有辨识度、避免撞脸和网红脸。